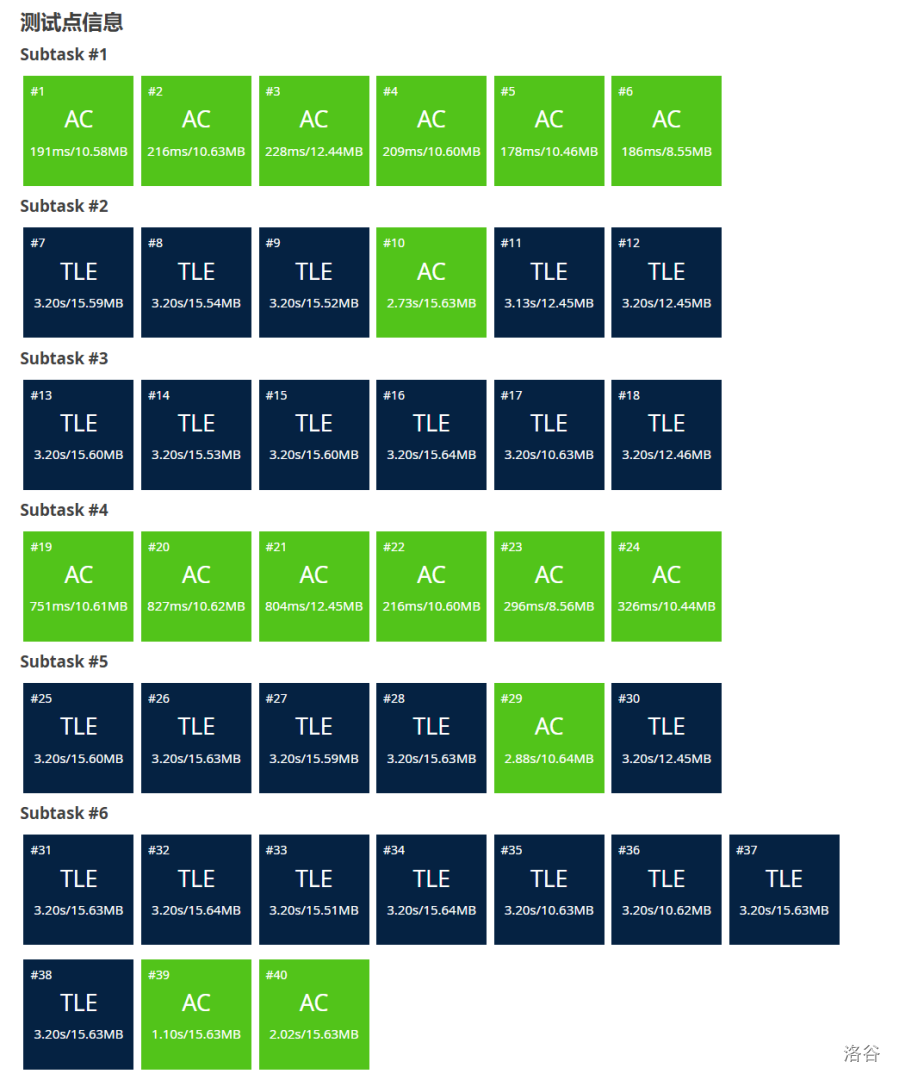
求卡常
- 板块P10000 [Ynoi2001] pri
- 楼主chenbs
- 当前回复0
- 已保存回复0
- 发布时间2024/8/24 12:46
- 上次更新2024/8/24 15:10:57
查看原帖
被骇客银狼阻止的越权访问保存失败
求卡常

暴力矩阵快速幂
我个人觉得高精度已经优化得非常好了(2^64 进制),主要是矩阵计算这里希望可以优化一下。
// #pragma GCC optimize(3,"Ofast","inline")
// #pragma G++ optimize(3,"Ofast","inline")
#include<bits/stdc++.h>
using namespace std;
int s,t,n,m;
typedef unsigned long long ull;
//=========================================================================================================
// 256 位大整数,10^18 进制,支持输入输出
#define _1e18 1000000000000000000
struct u256 {
	ull dat[4];
	inline ull & operator [] (int i) {
		return dat[i];
	}
	inline const ull & operator [] (int i) const {
		return dat[i];
	}
} k;
inline void div2(u256 &a) {
	ull t=a[3];
	a[3]=t>>1, t&=1, t=t*_1e18+a[2], a[2]=t>>1, t&=1, t=t*_1e18+a[1], a[1]=t>>1, t&=1, t=t*_1e18+a[0], a[0]=t>>1;
}
void read(u256 &a) {
	string s;
	cin>>s, a[0]=0,a[1]=0,a[2]=0,a[3]=0;
	for (int i=s.size()-1, j=0; i>=0; i-=18) {
		int st = max(0, i-17), len = i-st+1;
		a[j++] = (stoll(s.substr(st,len)));
	}
}
//=========================================================================================================
// 320 位大整数,2^64 进制,不支持输入输出,仅供中间计算
struct u320 {
	ull dat[5];
	inline ull & operator [] (int i) {
		return dat[i];
	}
	inline const ull & operator [] (int i) const {
		return dat[i];
	}
} inf;
inline void copy(u320 &a, u320 &b) {
	a[0]=b[0],a[1]=b[1],a[2]=b[2],a[3]=b[3],a[4]=b[4];
}
inline void clear(u320 &a) {
	a[0]=0,a[1]=0,a[2]=0,a[3]=0,a[4]=0;
}
inline void add(u320 &a, u320 &b, u320 &c) {
	__asm__("add %10,%0; adc %11,%1; adc %12,%2; adc %13,%3; adc %14,%4" // add 普通加法,adc 带进位加法
	: "=r"(c[0]), "=r"(c[1]), "=r"(c[2]), "=r"(c[3]), "=r"(c[4])
	: "0"(a[0]), "1"(a[1]), "2"(a[2]), "3"(a[3]), "4"(a[4]), "r"(b[0]), "r"(b[1]), "r"(b[2]), "r"(b[3]), "r"(b[4])
	: "cc" // 修改了标志
	);
}
inline bool cmp(u320 &a, u320 &b) {
	return a[4]<b[4] || a[4]==b[4] && (a[3]<b[3] || a[3]==b[3] && (a[2]<b[2] || a[2]==b[2] && (a[1]<b[1] || a[1]==b[1] && a[0]<b[0])));
}
inline bool cmp2(const u320 &a, const u320 &b) {
	return a[0]==b[0]&&a[1]==b[1]&&a[2]==b[2]&&a[3]==b[3]&&a[4]==b[4];
}
inline int mod_int(u320 &a, int b) {
	__int128 t=0;
	t=(        a[4])%b;
	t=((t<<64)+a[3])%b;
	t=((t<<64)+a[2])%b;
	t=((t<<64)+a[1])%b;
	t=((t<<64)+a[0])%b;
	return t;
}
//=========================================================================================================
struct matrix {
	u320 a[300][300];
	matrix() {}
	matrix(const matrix &b) {
		for(int i=0; i<n; i++)
			for(int j=0; j<n; j++)
				a[i][j] = b.a[i][j];
	}
	friend void mat_mul (matrix &x, matrix &y, matrix &z) {
		u320 tmp;
		for(register int i=0; i<n; i++)
			for(register int j=0; j<n; j++)
				z.a[i][j]=inf;
		for(register int i=0; i<n; i++)
			for(register int k=0; k<n; k++)
				if(!cmp2(x.a[i][k], inf))
					for(register int j=0; j<n; j++) {
						add(x.a[i][k], y.a[k][j], tmp);
						if(cmp(tmp, z.a[i][j])) copy(z.a[i][j], tmp);
					}
	}
} mp[2],ans,res[2];
//=========================================================================================================
int main() {
	ios::sync_with_stdio(0),cin.tie(0),cout.tie(0);
	inf[0]=inf[1]=inf[2]=inf[3]=inf[4]=1e18;
	cin>>s>>t;
	while(t--) {
		cin>>n>>m;
		read(k);
		for(int i=0; i<n; i++)
			for(int j=0; j<n; j++)
				copy(mp[0].a[i][j], inf);
		for(int i=0; i<m; i++) {
			int u,v;
			ull w;
			cin>>u>>v>>w, --u, --v;
			if(w < mp[0].a[u][v][0]) clear(mp[0].a[u][v]), mp[0].a[u][v][0]=w;
		}
		int first=1; // 不需要单位矩阵了
		int r=0,r2=0; // 拷贝矩阵很浪费时间,所以滚动使用
		while(1) {
			if(k[0]&1) {
				if(first) res[r]=mp[r2], first=0;
				else mat_mul(res[r],mp[r2],res[r^1]), r^=1;
			}
			if(k[0]==0 && k[1]==0 && k[2]==0 && k[3]==0) break;
			mat_mul(mp[r2],mp[r2],mp[r2^1]), r2^=1;
			div2(k);
		}
		for(int i=0; i<n; i++) {
			if(cmp2(res[r].a[0][i], inf)) cout<<"-1 ";
			else cout<<mod_int(res[r].a[0][i],998244353)<<" ";
		}
		cout<<'\n';
	}
	return 0;
}
加载中...